Warum ein KI-Modell allein noch keine Dokumentenverarbeitung bringt
Seit leistungsfähige KI-Sprachmodelle für jeden verfügbar sind, wirkt die Verarbeitung von Dokumenten auf den ersten Blick wie ein gelöstes Problem: ein KI-Modell, ein Prompt, ein sauber strukturiertes Ergebnis. In Gesprächen mit Unternehmen erlebe ich allerdings regelmäßig ein anderes Bild. Teams, die mit viel Energie eine selbst gebastelte Verarbeitungsstrecke auf Basis aktueller KI-Modelle aufgebaut haben, stellen im Produktivbetrieb fest, dass die letzten Prozentpunkte an Genauigkeit die teuersten sind – und dass Dokumente für Maschinen nach wie vor erstaunlich schwer zuverlässig zu lesen sind. Warum die Extraktion von Daten nur ein Baustein von vielen ist und welche Schritte tatsächlich über den Erfolg eines IDP-Projekts entscheiden, erfahren Sie in diesem Blogartikel.
Der Irrtum vom einen Modell
Ein Prototyp mit 50 ausgewählten Dokumenten funktioniert heute fast immer. Genau das macht den Einstieg so verführerisch – und den späteren Schritt in den Regelbetrieb so schmerzhaft. Denn im Tagesgeschäft kommt nicht das saubere Musterdokument an, sondern die Realität: ein schlecht gescanntes Fax, ein 120-seitiges PDF mit mehreren Vorgängen, ein Foto vom Smartphone, eine E-Mail mit fünf Anhängen in vier Formaten, handschriftliche Ergänzungen am Seitenrand.
Hinzu kommt: Ein Modell liefert immer ein Ergebnis. Auch dann, wenn die Information im Dokument gar nicht enthalten ist… Für Prozesse, in denen Fristen laufen, Leistungen bewilligt und Zahlungen ausgelöst werden, ist ein plausibel klingendes, aber falsches Ergebnis das größere Risiko als gar kein Ergebnis. Genau deshalb ist die Frage „Wie gut liest das Modell?" die falsche Ausgangsfrage. Die richtige lautet: Was passiert vor und nach dem Auslesen?
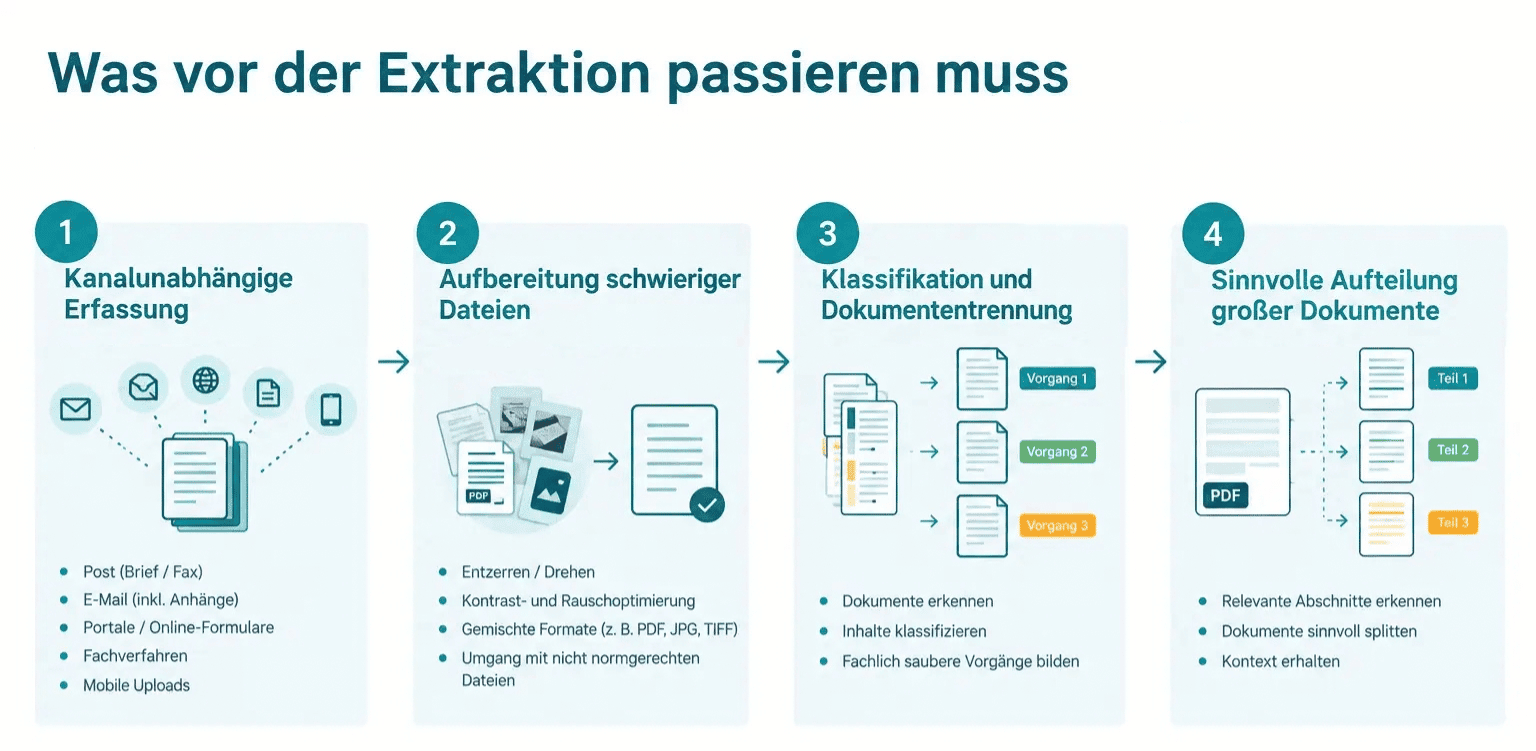
Was vor der Extraktion passieren muss
Ein großer Teil der Qualität entsteht, bevor überhaupt eine KI zum Einsatz kommt. Dazu gehören:
- Kanalunabhängige Erfassung – Post, E-Mail, Portale, Fachverfahren und mobile Uploads liefern dieselben Inhalte in sehr unterschiedlicher Qualität
- Aufbereitung schwieriger Dateien – Entzerren, Drehen, Kontrast- und Rauschoptimierung, Umgang mit gemischten Formaten und Dateien, die technisch nicht der Norm entsprechen
- Klassifikation und Dokumententrennung – aus einem Stapel werden einzelne, fachlich saubere Vorgänge
- Sinnvolle Aufteilung großer Dokumente – nur wenn ein Modell den richtigen Ausschnitt sieht, arbeitet es präzise und wirtschaftlich
Diese Schritte sind wenig spektakulär. Sie entscheiden aber darüber, ob eine Extraktion überhaupt eine faire Chance bekommt.
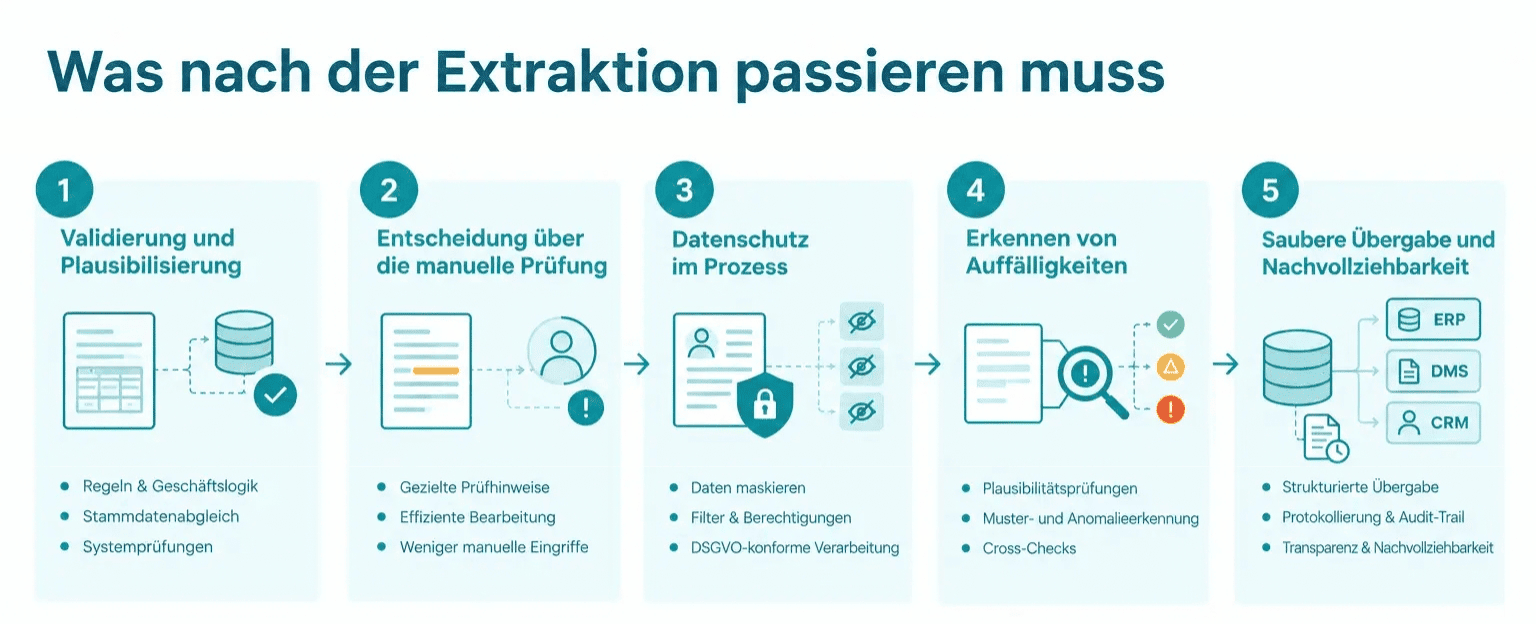
Was nach der Extraktion passieren muss
Noch wichtiger ist, was mit den ausgelesenen Daten geschieht. Ein extrahiertes Feld ist zunächst nur eine Vermutung – ein belastbares Prozessergebnis wird daraus erst durch nachgelagerte Schritte:
- Validierung und Plausibilisierung – Abgleich gegen Regeln, Stammdaten und Bestandssysteme, statt Werte ungeprüft weiterzureichen
- Entscheidung über die manuelle Prüfung – nicht jeder Vorgang, sondern gezielt das einzelne unsichere Feld wird einem Menschen vorgelegt
- Datenschutz im Prozess – Masken, Filter und das Schwärzen personenbezogener Daten, bevor Informationen weiterverarbeitet oder archiviert werden
- Erkennen von Auffälligkeiten – Unstimmigkeiten und Manipulationsversuche fallen auf, wenn Daten systematisch gegeneinander geprüft werden
- Saubere Übergabe und Nachvollziehbarkeit – Zielsysteme brauchen strukturierte Daten, Revisionssicherheit braucht eine lückenlose Protokollierung
Erst dieses Zusammenspiel erlaubt eine hohe Dunkelverarbeitungsquote, also einen hohen Automatisierungsgrad ohne manuelle Eingriffe – und das, ohne dass Sie die Kontrolle über den Prozess abgeben.
Für jeden Schritt die passende Technologie
Eine weitere Erkenntnis aus über 20 Jahren Projekterfahrung: Es gibt nicht das eine Modell für alles. Für strukturierte Dokumente wie z.B. Formulare ist eine etablierte Erkennungstechnologie oft schneller, günstiger und stabiler als ein großes Sprachmodell. Für unstrukturierte Dokumente, für das Verstehen von Kundenanliegen oder für Zusammenfassungen spielt ein Sprachmodell seine Stärken aus. Für die Klassifikation wiederum eignet sich häufig ein spezialisiertes, schlankes Modell.
Entscheidend ist deshalb die Orchestrierung: Jeder Schritt bekommt die Technologie, die dort das beste Verhältnis aus Genauigkeit, Geschwindigkeit und Kosten liefert. Und weil sich der Markt für KI-Modelle schneller verändert als jeder Projektplan, muss diese Zuordnung austauschbar bleiben. Wer sich fest an ein einzelnes Modell bindet, baut ein Ablaufdatum in seine Prozesse ein.
Worauf Sie bei der Auswahl achten sollten
Fragen Sie einen Anbieter deshalb nicht nur nach Erkennungsraten, sondern nach der gesamten Strecke: Wie werden schwierige Eingangsdateien aufbereitet? Wie werden Ergebnisse validiert? Wie wird entschieden, was ein Mensch prüft? Wie lassen sich Modelle wechseln, ohne den Prozess neu zu bauen? Und wo läuft das Ganze – in der Cloud oder in Ihrem eigenen Rechenzentrum?
Genau auf diese Anforderungen ist unsere Plattform ausgelegt. Mit der Low-Code-Plattform NOVO CxP bilden Sie den kompletten Weg vom Eingangskanal bis zur Übergabe an Ihre Zielsysteme ab – inklusive Klassifikation, Extraktion, Validierung und den Prüfschritten dazwischen. Das NOVO AI Studio ermöglicht den flexiblen Einsatz von KI-Sprachmodellen an genau den Stellen, an denen sie den größten Nutzen bringen, mit Vorlagen für typische Dokumentenprozesse. Und mit dem NOVO BI Board sehen Sie in Echtzeit, wie Ihre Prozesse tatsächlich laufen, wo Engpässe entstehen und an welcher Stelle sich Optimierung lohnt.
Fazit: Die Strecke entscheidet, nicht das Modell
Künstliche Intelligenz hat die intelligente Dokumentenverarbeitung grundlegend verändert – sie ersetzt damit aber nicht die vielen Schritte, die davor und danach nötig sind. Wer Dokumentenprozesse produktiv, verlässlich und regelkonform automatisieren will, braucht mehr als ein gutes Modell: eine durchgängige Strecke von der Aufbereitung über die Extraktion bis zu Validierung, Datenschutz und gezielter menschlicher Prüfung. Die Extraktion ist dabei ein wichtiger Schritt. Aber eben nur einer von vielen.