Was ist OCR – und warum reicht sie allein nicht mehr?
OCR steht für Optical Character Recognition, im Deutschen optische Zeichenerkennung. Die Technologie wandelt Bildinformationen, also Pixel aus einem Scan, einem Foto oder einem gerasterten PDF, in maschinenlesbaren Text um. Aus einem Bild, in dem ein Mensch Buchstaben erkennt, wird eine Zeichenkette, mit der ein Computer arbeiten kann.
Das ist eine notwendige, aber eine sehr begrenzte Leistung. OCR beantwortet ausschließlich die Frage: Welche Zeichen stehen an welcher Stelle des Dokuments? Sie beantwortet nicht, was diese Zeichen bedeuten, ob es sich um eine Rechnung oder einen Widerspruch handelt oder welche der siebzehn Zahlen auf dem Blatt der zu buchende Betrag ist. Genau diese Fragen entscheiden aber darüber, ob ein Dokument automatisiert weiterverarbeitet werden kann.
- Wie funktioniert OCR technisch?
- OCR, ICR, OMR: die Verfahren im Überblick
- Wo OCR an ihre Grenzen stößt
- Warum 99 % Zeichengenauigkeit nicht genügt
- Was OCR leistet – und was KI ergänzt
- Wofür OCR weiterhin unverzichtbar ist
- Die Wahl der passenden Software: Lösungen von inovoo
- Fazit: OCR ist die Grundlage, aber nicht die Lösung
Wie funktioniert OCR technisch?
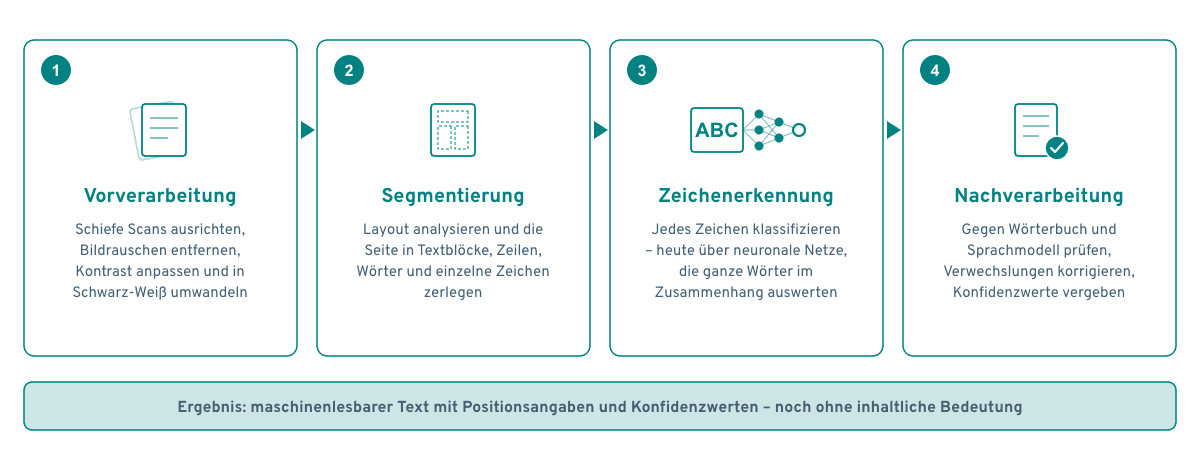
Die optische Zeichenerkennung läuft in vier Stufen ab:
- Vorverarbeitung: Das Bild wird für die Erkennung aufbereitet – Ausrichtung schiefer Scans, Entfernen von Bildrauschen und Scan-Artefakten, Kontrastanpassung und häufig eine Umwandlung in Schwarz-Weiß (Binarisierung). Die Qualität dieser Stufe bestimmt maßgeblich das Endergebnis.
- Segmentierung: Das System analysiert das Layout und zerlegt die Seite in ihre Bestandteile – Textblöcke, Spalten, Zeilen, Wörter und schließlich einzelne Zeichen. Hier entscheidet sich auch, in welcher Reihenfolge der Text gelesen wird.
- Zeichenerkennung: Jedes isolierte Zeichen wird klassifiziert. Frühere Verfahren arbeiteten mit Musterabgleich gegen gespeicherte Zeichenvorlagen oder mit Merkmalsextraktion (Anzahl der Linien, Schleifen, Schnittpunkte). Heutige Engines nutzen neuronale Netze, die ganze Wortbilder und Zeilen im Zusammenhang auswerten.
- Nachverarbeitung: Das Ergebnis wird gegen Wörterbücher und Sprachmodelle geprüft, um typische Verwechslungen zu korrigieren – „rn" statt „m", „0" statt „O", „1" statt „l". Gleichzeitig entsteht für jedes Zeichen und jedes Wort ein Konfidenzwert, also ein Maß für die Erkennungssicherheit.
Das Ergebnis ist eine Textebene mit Positionsangaben. Bei der Archivierung wird sie dem Bild als unsichtbare Schicht hinterlegt – so entsteht ein durchsuchbares PDF, das optisch aussieht wie das Original.
OCR, ICR, OMR: die Verfahren im Überblick
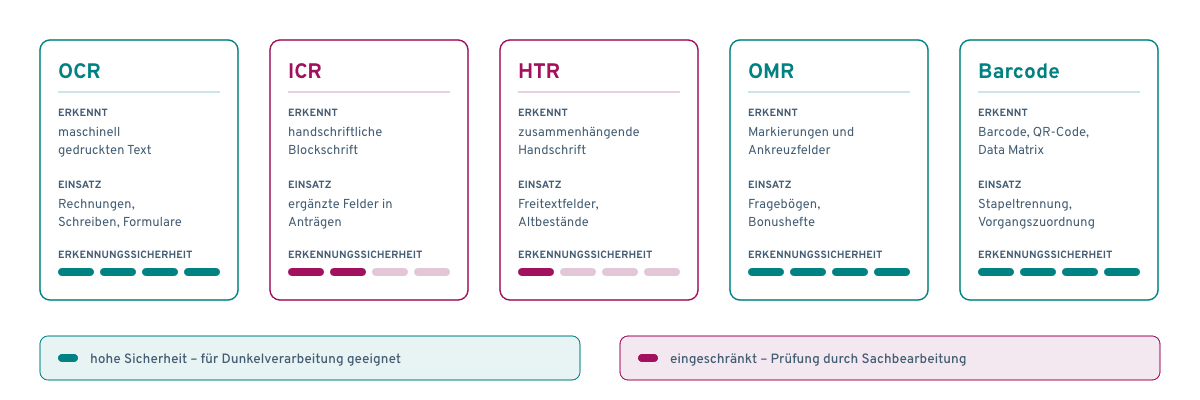
In der Praxis kommen mehrere Erkennungsverfahren parallel zum Einsatz, die im Alltag oft unter dem Sammelbegriff OCR zusammengefasst werden. Streng genommen bezeichnet OCR nur die Erkennung maschinell gedruckten Textes – also alles, was aus einem Drucker oder einer Druckmaschine stammt: Rechnungen, Anschreiben, ausgefüllte Formularvordrucke.
Für Handschrift sind eigene Verfahren zuständig. ICR (Intelligent Character Recognition) liest handschriftliche Blockschrift, wie sie in den Kästchenfeldern von Anträgen vorkommt, wo jeder Buchstabe einzeln steht. HTR (Handwritten Text Recognition) geht darüber hinaus und erkennt zusammenhängende Handschrift, also frei geschriebene Zeilen in Freitextfeldern oder in historischen Aktenbeständen. OMR (Optical Mark Recognition) wiederum liest überhaupt keinen Text, sondern ausschließlich Markierungen: gesetzte Kreuze und gefüllte Felder in Fragebögen, Wahlunterlagen oder Bonusheften. Hinzu kommt das Lesen codierter Kennungen – Barcode, QR-Code und Data Matrix –, mit dem sich große Scanstapel automatisch in einzelne Vorgänge trennen und Dokumente einem bereits bekannten Vorgang zuordnen lassen.
Für die Praxis wichtig ist, dass die Zuverlässigkeit dieser Verfahren sehr unterschiedlich ausfällt. Codierte Kennungen und Ankreuzfelder werden nahezu fehlerfrei gelesen, gedruckter Text bei guter Vorlage ebenfalls sehr sicher. Handschriftliche Blockschrift erreicht bereits deutlich niedrigere Werte – und zusammenhängende Handschrift bleibt auch mit modernen Verfahren ein Fall für die Prüfung durch Menschen. Wer Prozesse automatisieren will, muss deshalb wissen, welches Verfahren auf welchem Teil seiner Dokumente arbeitet.
Wo OCR an ihre Grenzen stößt
OCR ist nach Jahrzehnten der Entwicklung technisch ausgereift. Ihre Grenzen liegen nicht in mangelnder Qualität, sondern in dem, was sie konzeptionell nicht leisten kann:
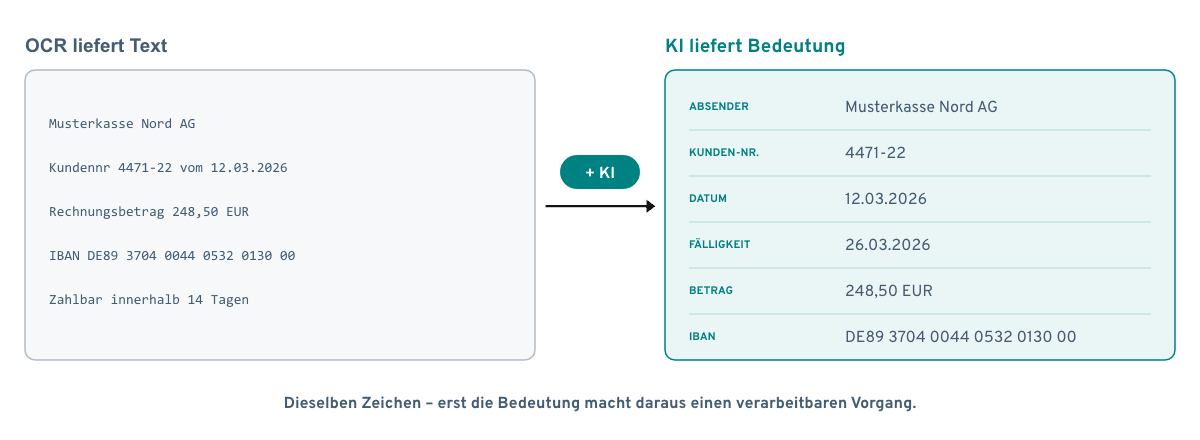
- OCR liefert Text, aber keine Bedeutung. Auf einer Rechnung erkennt OCR zuverlässig alle Zahlen. Welche davon die Rechnungsnummer, welche das Nettoentgelt und welche eine Kundennummer ist, ergibt sich daraus nicht. Diese Zuordnung muss ein zweiter Schritt leisten – die Datenextraktion.
- OCR kennt das Dokument nicht. Ob ein Schreiben eine Kündigung, ein Widerspruch oder eine Adressänderung ist, entscheidet sich am Inhalt, nicht an den Zeichen. Diese Einordnung leistet die Dokumentenklassifizierung.
- Klassische Auswertung ist layoutabhängig. Wird OCR mit vorlagenbasierten Regeln kombiniert – „lies den Betrag aus dem Rechteck bei Koordinate X" –, funktioniert das nur so lange, wie das Layout unverändert bleibt. Bei tausenden Absendern mit eigenen Vorlagen ist dieser Ansatz nicht wirtschaftlich pflegbar.
- Die Eingangsqualität schwankt stark. Ein sauberer 300-dpi-Scan ist der Idealfall. Realität sind Smartphone-Fotos mit Schatten und Perspektivverzerrung, mehrfach kopierte Vorlagen, Faxe, Stempel über Textfeldern und Knicke quer durch die Betragszeile.
- Tabellen und mehrspaltige Layouts brechen die Leserichtung. Sobald Inhalte in Spalten oder verschachtelten Tabellen stehen, ist die Segmentierung fehleranfällig – Positionen werden verschoben zugeordnet oder Zeilen vermischt.
- Der Vorgangszusammenhang fehlt. Eine E-Mail mit fünf Anhängen ist ein Geschäftsvorfall. OCR sieht fünf unabhängige Bilddateien.
Warum 99 % Zeichengenauigkeit nicht genügt
Ein Rechenbeispiel macht das Kernproblem deutlich. Angenommen, eine OCR-Engine erkennt 99 % aller Zeichen korrekt – ein guter Wert. Ein Feld wie eine 20-stellige IBAN besteht aus 20 Zeichen. Die Wahrscheinlichkeit, dass alle korrekt erkannt werden, liegt bei 0,99²⁰ – also bei rund 82 %. Fast jedes fünfte Feld enthält damit einen Fehler.
Für die Suche in einem Archiv ist das unerheblich, dort genügt Näherung. Für eine automatisierte Buchung oder eine Leistungsentscheidung ist es untragbar. Zeichengenauigkeit und Feldgenauigkeit sind nicht dasselbe – und nur die zweite entscheidet, ob ein Prozess wirklich automatisiert läuft. Deshalb ist die Datenvalidierung kein optionaler Zusatz, sondern der Schritt, der aus erkanntem Text belastbare Daten macht: Ein Prüfziffernverfahren erkennt die fehlerhafte IBAN, ein Abgleich mit dem Bestand korrigiert sie.
Was OCR leistet – und was KI ergänzt
Moderne Lösungen zur intelligenten Dokumentenverarbeitung ersetzen OCR nicht, sie bauen darauf auf. Die Umwandlung von Bildpunkten in maschinenlesbaren Text leisten beide Ansätze gleichermaßen – das ist die gemeinsame Grundlage. Alles, was darüber hinausgeht, gelingt jedoch erst mit KI-Ergänzung: Die Dokumentart und das Anliegen zu erkennen, Felder auch ohne hinterlegte Vorlage richtig zuzuordnen, Freitext inhaltlich auszuwerten, die gefundenen Angaben gegen die eigenen Bestandsdaten zu prüfen und mehrere Anhänge einer E-Mail als einen zusammenhängenden Geschäftsvorfall zu behandeln – all das liegt außerhalb dessen, was optische Zeichenerkennung leisten kann.
Ein Sonderfall ist der Umgang mit Unsicherheit. OCR liefert hier durchaus etwas, nämlich Konfidenzwerte für einzelne Zeichen und Wörter. Was sie nicht liefert, ist eine Aussage darüber, wie sicher ein fachliches Feld als Ganzes erkannt wurde – und genau diese Angabe braucht der Prozess, um zu entscheiden, ob ein Vorgang automatisiert durchlaufen darf oder der Sachbearbeitung vorgelegt werden muss.
Der entscheidende Unterschied liegt im Umgang mit dem Unbekannten. KI-Modelle – insbesondere Large Language Models – erschließen sich den Inhalt eines Dokuments aus dem Kontext und finden die gesuchte Angabe auch dann, wenn das Layout neu ist. Damit entfällt die Pflege von Vorlagen, die bei vorlagenbasierten Systemen den größten Teil des Betriebsaufwands ausmacht.
Wofür OCR weiterhin unverzichtbar ist
Bei aller Kritik: Ohne OCR gibt es keine Dokumentenautomatisierung. Sie bleibt die Eingangsstufe, auf der alles Weitere aufsetzt, und in einigen Anwendungsfällen ist sie schon für sich genommen der komplette Nutzen:
- Archivdigitalisierung: Papierbestände werden als durchsuchbares PDF/A abgelegt und damit erstmals recherchierbar.
- Volltextsuche in Bestandsakten: Für die Recherche genügt eine gute Trefferquote, es braucht keine feldgenaue Extraktion.
- Stapelverarbeitung von Papierpost: Barcodes und Trennseiten teilen große Scanstapel automatisch in einzelne Vorgänge.
- Nachweispflichten: Die Textebene über dem Originalbild dokumentiert, was tatsächlich eingegangen ist – die Bildinformation bleibt revisionssicher erhalten.
Die Wahl der passenden Software: Lösungen von inovoo
In NOVO CxP ist OCR ein integrierter Baustein und kein separates Werkzeug: Dokumente aus allen Eingangskanälen werden erfasst, aufbereitet und ausgelesen, anschließend klassifiziert, extrahiert und validiert – bis der geprüfte Vorgang im Fachsystem landet. Die Verfahren für gedruckten Text, Handschrift, Ankreuzfelder und Barcodes greifen dabei auf demselben Dokument zusammen.
Für Dokumente, an denen klassische Verfahren scheitern – uneinheitliche Layouts, Freitext, unbekannte Absender –, ergänzt NOVO AI Studio die Plattform um LLM-basierte Auswertung. Der Betrieb ist im eigenen Rechenzentrum ebenso möglich wie in der Cloud, was insbesondere bei Sozial- und Gesundheitsdaten relevant ist.
Wie zuverlässig die Erkennung im Echtbetrieb arbeitet, macht das NOVO BI Board sichtbar: Es zeigt je Dokumentart, wie viele Vorgänge automatisiert durchlaufen und an welchen Feldern Nachbearbeitung entsteht. Genau diese Auswertung ist die Grundlage, um die Erkennung gezielt zu verbessern statt pauschal nachzujustieren.
Fazit: OCR ist die Grundlage, aber nicht die Lösung
Wer heute über die Automatisierung seiner Dokumentenprozesse nachdenkt, sollte OCR nicht als Auswahlkriterium behandeln. Die Frage ist nicht, ob eine Lösung Zeichen erkennt – das können alle. Die Frage ist, was danach passiert: ob das System den Inhalt versteht, seine eigene Unsicherheit erkennt und die Daten so übergibt, dass der Fachprozess ohne manuellen Zwischenschritt weiterläuft.
OCR liefert das Rohmaterial. Erst eine weitere Verarbeitung liefert daraus ein fertiges, optimales Ergebnis.
Sie möchten wissen, wie zuverlässig Ihre Dokumentarten tatsächlich verarbeitet werden können? Vereinbaren Sie eine Demo – wir schauen uns Ihren Eingangspostprozess gemeinsam an.